RLHF: Reinforcement Learning from Human Feedback
2026年10月の再サーベイ: 研究史・重要文献・最近の進展を整理した新版を追加しました(2026年10月3日基準)。以下は従来のメモです。定義・適用条件の訂正は新版を参照してください。
読み物
- BrainPad ざっくりわかるRLHF(人間からのフィードバックを用いた強化学習)
- 概要
- RLHFは、AIモデルの出力に「人間の価値基準(人間の好み)」が反映されるための学習プロセスである。
- RLHFでは、与えられたプロンプトに対して学習結果を参照して応答文を生成(=行動の決定)し、その文章がどれほど望ましいかという観点で評価(=報酬)が決まり、それを基に応答文の生成モデルを更新していきます。
- 強化学習を実施する前に、報酬をどうやって与えるか(数値化するか)を決める必要があります。この時、「報酬の決め方」に対して「モデル作成者にとっての好ましさ」を反映させた設計にしておきます。
- 具体的には、あるプロンプトに対してAIが生成した応答文の良し悪しを人間がランク付けし、そのランク付されたデータセットを使って「より望ましい応答文とはどんな感じの文章なのか」を評価できる報酬モデルを作成するわけです。
- RLHFの学習プロセス
- ステップ0:大規模言語モデルの用意
- RLHFを行う場合、なるべく優秀な言語モデルを用意します。
-
ステップ1:教師あり学習で既存の言語モデルをfine-tuning

- 人間がプロンプトとそれに対応した応答文を作り、それを教師データとして既存の大規模言語モデルに対して教師あり学習でfine-tuning(SFT)する
- どんな「望ましい出力」を用意するかは、完全にモデル作成者の判断であり、したがってこのデータセットがRLHF適用後のモデルの「性格」を決める一因になります。
-
ステップ2:出力のパターンの収集と “報酬モデルのトレーニング”

-
報酬モデルの学習。contextが入力プロンプトであり、それがPolicyに渡され応答文が生成される。これが、その時点での報酬モデルと応答文を評価する人間に渡される。両者の報酬の差分をフィードバックとして報酬モデルが更新される
- まず、ステップ1でfine-tuningしたモデルを利用して、1つのプロンプトに対する複数の応答を用意します。
- モデル作成者は、その応答文をより好ましいものから順に順位付けします。そして、これらを使って報酬モデルを学習させます。報酬モデルをこのように学習させることで、似たようなプロンプトが与えられた時に、より望ましいと評価された応答(=よりランクが高かった応答)に近い応答文が、より報酬が高くなります。
- 結果として、より好ましいと評価された応答文に近い応答文が生成される確率が高まります。
- なお、報酬モデルの望ましさの評価観点は以下の通りです。
- 真実性:口から出まかせを言わないかどうか
- 無害性:人間社会の規範に従った内容かどうか
- 有益性:人間の意図に沿った回答かどうか
-
- ステップ3:報酬モデルに対してポリシーを最適化

- PPO(Proximal Policy Optimization )アルゴリズムを用いた生成モデルの強化学習のステップ。この場合のlossは、PPOアルゴリズムにおけるCriticによる価値予測とそれに対する実際の報酬という2つの要素から計算される。
- ステップ2で学習した報酬モデルに対してポリシーを最適化することで、報酬モデルに最適な(最も望ましい応答文を返す)応答文の生成モデルを作ることができます。
- データセットから学習に使用していないプロンプトを抽出してきます。次に、その時点でのポリシーに従って、抽出したプロンプトから応答文を生成し、生成された応答文を報酬モデルに与えて報酬を計算します。得られた報酬を使って、現在採用しているポリシーを、より高い報酬が得られると期待できるポリシーへ更新します。
- ステップ0:大規模言語モデルの用意
- 概要
- RLHF (人間のフィードバックからの強化学習) の図解
- RLHFの3つのステップ
- (1) 言語モデルの事前学習
- とりあえずでかい言語モデルを学習する、ここにGPU リソースがめっちゃいる
- OpenAI とか Anthropic はいい感じに蒸留してる
- (2) 報酬モデルの学習
- 基本的な目標は、テキストから人間の好みを表す数値 (スカラー報酬) を取得すること
- ヒューマン・アノテーターは、言語モデルから生成されたテキスト出力をランク付けします
- テキストのランク付けには複数の方法があります。
- 同じプロンプトで条件付けされた2つの言語モデルから生成されたテキストをユーザーに比較させるなど
- (3) 強化学習による言語モデルのファインチューニング
- 10Bや100B以上のパラメータを持つモデル全体のファインチューニングは法外なコストがかかるため、言語モデルのパラメータは凍結して学習します(詳しくはLoRAやSparrow LMを参照)
- 報酬関数 は、これまで説明したすべてのモデルを1つの「RLHF」に統合するものです。データセットからプロンプト x が与えられると、2つのテキスト y1, y2 が生成されます。現在のポリシーのテキストはプリファレンスモデルに渡され、プリファレンスモデルは「preferability」というスカラー概念を返します。このテキストは、ベースモデルからのテキストと比較され、両者の差に対するペナルティを計算します。OpenAI、Anthropic、DeepMindなどの論文では、このペナルティは、トークン上のこれらのシーケンス間の「KL divergence」のスケーリングバージョンとして設計されています。
- このペナルティがないと、最適化によって報酬モデルを騙して、意味不明なテキストが生成されるようになります。
- Amazon / RLHF とは何ですか?
- 論文紹介:Reinforcement Learning from Human Feedback(コニカミノルタ Forxai Blog。旧URL:
https://forxai.konicaminolta.com/blog/061、2026-09-30時点で記事本文ではなくサイトトップへ転送)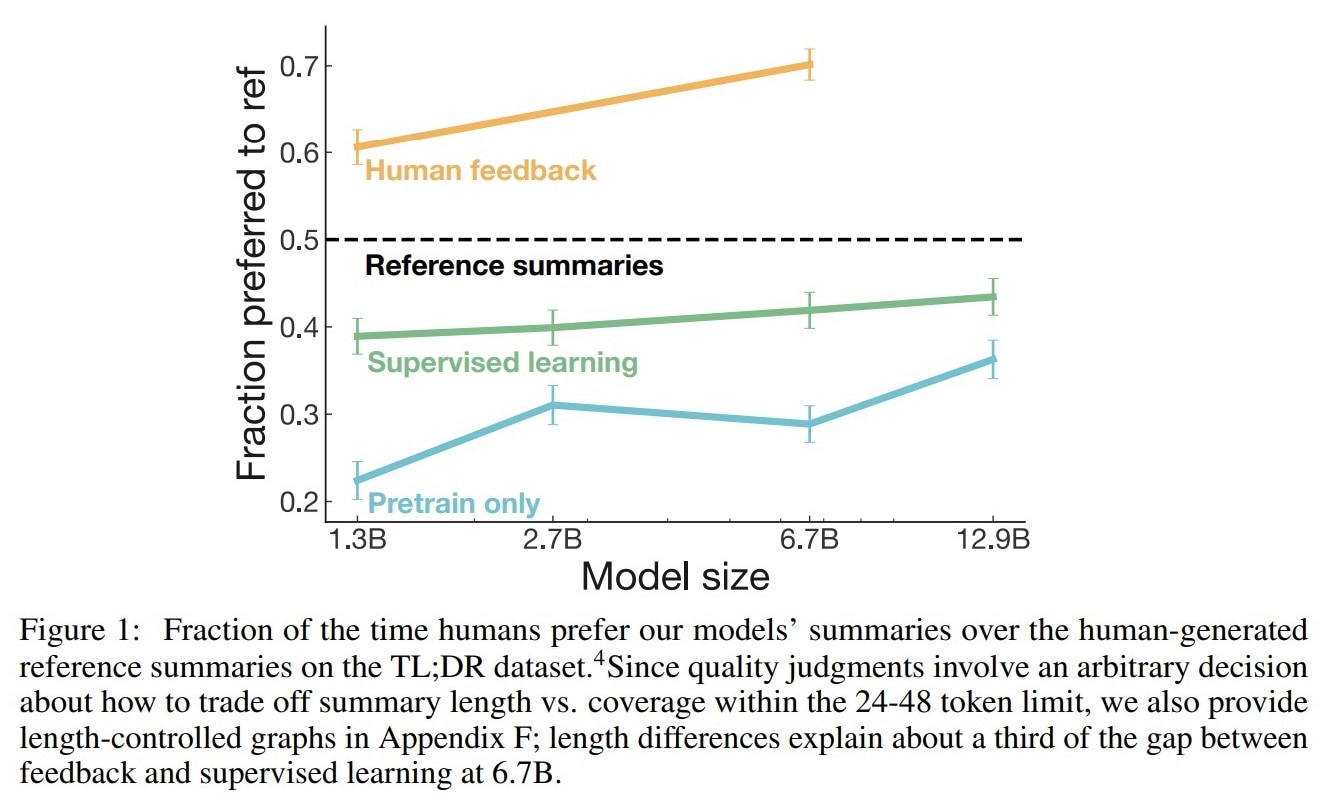
- STEP 1. Collect demonstration data, and train supervised policy
- プロンプトデータからサンプリング
- 人間が出力例を執筆
- 出力例をGPT-3の教師ありfine-tuningに利用
- STEP 2. Collect comparison data, and train a reward model
- プロンプトを複数モデルに入れて、出力を取得
- 人間が出力にランク付け
- ランク付けをreward modelの学習に利用
- STEP 3. Optimize a policy against the reward model using reinforcement learning
- プロンプトデータセットから新しいプロンプトをサンプリング
- policyで結果出力
- STEP2で学習したreward modelで報酬を計算
- 報酬をもとにpolicyを更新(with PPO)
- STEP 1. Collect demonstration data, and train supervised policy
- ChatGPT 人間のフィードバックから強化学習した対話AI
- 東大、今井先生のスライド、これ全部読んだ方がいい
画像欠落: 以下8点のスライド画像は期限付きURLで、2026-09-30時点では表示できません。 誤った代替画像には置換せず、出典スライドへのリンクを残しています。 期限付き署名クエリは削除し、非機密の画像IDだけを以下に保持します。
307499776-6bb26e2b-e8ae-4f08-ac06-13d639514651.png(期限付き署名クエリは削除) 307500406-9e78d416-7328-49e1-bcda-031efcb4f4ce.png(期限付き署名クエリは削除) 307500410-f4a5068b-a6bc-4bd3-81fe-1d7870c03a52.png(期限付き署名クエリは削除) 307500414-38b0aa2e-10a7-4105-a4a9-49e29029edd9.png(期限付き署名クエリは削除) 307500415-0ee7d373-37bb-421e-9db3-889b5615df89.png(期限付き署名クエリは削除) 307500416-2e5d6da6-3948-4b73-bd97-2d6a50702613.png(期限付き署名クエリは削除) 307500418-a5442abd-8981-4adb-b39e-47916834120d.png(期限付き署名クエリは削除) 307500419-53bd22d1-0fff-4948-a046-0eb770dd0b4c.png(期限付き署名クエリは削除) - 東大、今井先生のスライド、これ全部読んだ方がいい